ถาม ChatGPT เรื่องนโยบายลางานของบริษัทคุณ มันมีโอกาสตอบมั่วสูง ไม่ใช่เพราะมันโง่ แต่เพราะมันไม่เคยเห็นเอกสารของคุณ RAG คือเทคนิคที่ทำให้ AI ค้นเอกสารบริษัทก่อนตอบ ชื่อเต็ม Retrieval-Augmented Generation บางคนเรียก RAG AI บอทตอบตามข้อมูลองค์กร หรือ RAG chatbot หัวใจคือทำให้ AI ตอบจากเอกสารบริษัทคุณเอง และเป็นแนวทางที่ผู้ให้บริการรายใหญ่อย่าง Google Cloud อธิบายและมีผลิตภัณฑ์รองรับ สำหรับระบบ AI ที่ต้องตอบจากข้อมูลภายในหรือข้อมูลที่เปลี่ยนบ่อย อธิบายแบบไม่ต้องรู้โค้ด
AI ทั่วไปตอบจากอะไร
โมเดลภาษาเรียนจากข้อมูลจำนวนมหาศาลตอนฝึก มันจึงเก่งเรื่องความรู้ทั่วไป แต่ไม่มีเอกสารภายในของคุณ อย่างราคาสินค้า สัญญาลูกค้า หรือคู่มือภายใน เป็นบริบทตอนตอบ และเมื่อไม่รู้ มันมีแนวโน้ม "เดาอย่างมั่นใจ" ซึ่งอันตรายกว่าตอบว่าไม่รู้
RAG คือ 3 ขั้นตอน ค้น เสริม สร้างคำตอบ
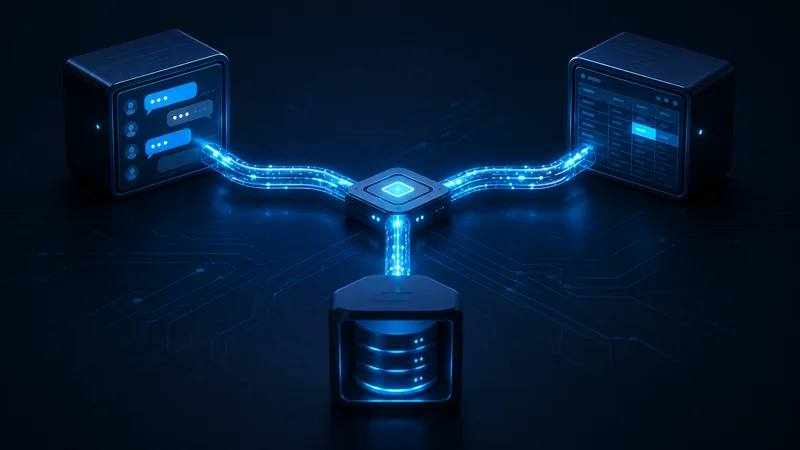
ก่อนเริ่ม ต้องเตรียมคลังความรู้ก่อน เอกสารองค์กร คู่มือ สัญญา FAQ ถูกหั่นเป็นชิ้นย่อยแล้วแปลงเป็นดัชนีแบบ vector ที่ค้นด้วย "ความหมาย" ได้ แทนการจับคำตรงตัวอย่างเดียว ทำกับเอกสารชุดแรกและทำซ้ำเมื่อมีเอกสารใหม่หรือแก้ไข จากนั้นทุกคำถามจะผ่าน 3 ขั้นนี้
- 1. ค้น ขั้นที่ตำราเรียก Retrieval ระบบไปดึงเอกสารที่เกี่ยวข้องที่สุดมาไม่กี่ชิ้น
- 2. เสริม ขั้น Augmentation แนบเอกสารที่ดึงมาไปกับคำถามเป็นบริบท
- 3. สร้างคำตอบ ขั้น Generation AI ถูกสั่งให้ตอบโดยอ้างอิงเฉพาะข้อมูลที่ดึงมา และบอกแหล่งที่มาได้ถ้าออกแบบให้ส่งและแสดงที่มาไว้
ตัวอย่างจากระบบที่เราสร้างเองคือเดโมตอบคำถามแบบแผนประกัน ข้อมูลเป็นของบริษัทสมมุติแต่ระบบทำงานจริง ถ้าถามโมเดลตรงๆ ว่า "แผนนี้คุ้มครองอะไร เงื่อนไขยังไง" มันไม่มีข้อมูลแผนนั้น จึงมีแนวโน้มตอบจากแผนประกันทั่วไปที่เคยเห็น หรือบอกว่าไม่ทราบ เราจึงให้ระบบดึงข้อมูลแผนในคลังของบริษัทสมมุติมาแนบก่อน ไม่ใช่กรมธรรม์ของบริษัทจริง แล้วสั่งให้ Gemini ตอบโดยยึดข้อมูลที่แนบ คำตอบจึงอ้างอิงแผนที่ดึงมา และตรวจย้อนได้ว่ามาจากแผนไหน
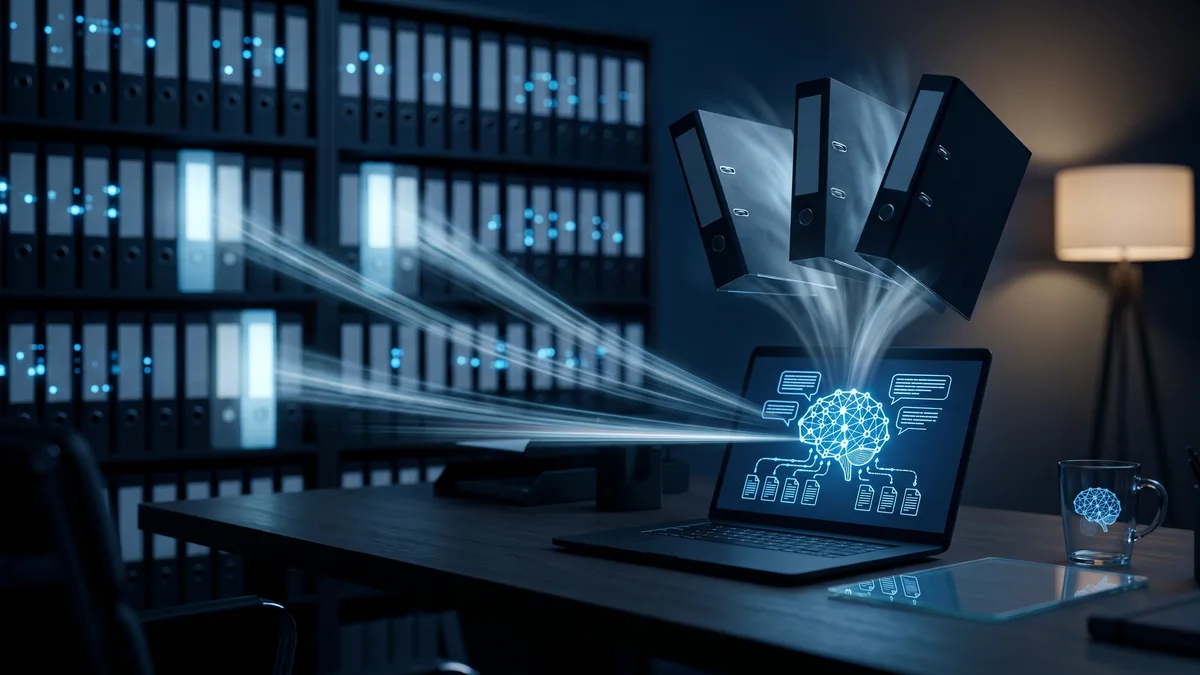
AI ทั่วไปตอบจากสิ่งที่มันเคยอ่าน RAG ให้มันเปิดคู่มือบริษัทคุณก่อนตอบ
RAG ต่างจาก Fine-tuning หรือ train โมเดลเองยังไง
การ fine-tune คือฝึกโมเดลเพิ่มเพื่อปรับพฤติกรรมหรือรูปแบบการตอบ ถ้าต้องการเปลี่ยนสิ่งที่โมเดลเรียนไว้ ต้องฝึกเพิ่มอีกรอบ RAG ดึงข้อมูลจากคลังเอกสารขณะตอบ อัปเดตเอกสารและสร้างดัชนีใหม่ คำถามครั้งถัดไปก็มีเอกสารชุดใหม่ให้ดึงโดยไม่ต้องฝึกโมเดล ส่วนคำตอบจะตามแค่ไหนต้องทดสอบ เหมาะกับข้อมูลองค์กรที่เปลี่ยนบ่อย และแสดงได้ว่าระบบดึงเอกสารใดมาเป็นบริบท ถ้าออกแบบการอ้างอิงไว้ ซึ่งสำคัญมากเวลาผิดพลาด ผู้ให้บริการรายใหญ่อธิบายแนวทางนี้และมีผลิตภัณฑ์รองรับ ดูคำอธิบายของ Google Cloud ประกอบได้
4 งานในองค์กรที่ใช้ RAG ได้จริง
- แชตบอตตอบคำถามพนักงานสำหรับงาน HR หรือ IT helpdesk จากคู่มือภายใน แบบที่หลายคนเรียกว่า RAG chatbot
- ผู้ช่วยทีมขาย ดึงข้อมูลสินค้า ราคา เงื่อนไขจากเอกสารล่าสุดเท่าที่คลังได้รับการอัปเดต
- สรุปและค้นสัญญา/เอกสารกฎหมายจำนวนมาก
- ฐานความรู้ให้ AI Agent ค้นข้อมูลประกอบก่อนทำงานอัตโนมัติ งานที่เสี่ยงต้องมีเงื่อนไขควบคุมหรือคนตรวจ
ถ้ายังไม่แน่ใจว่าธุรกิจคุณถึงจุดที่ควรมีระบบแบบนี้หรือยัง เช็คได้จาก 5 สัญญาณว่าธุรกิจคุณพร้อมใช้ AI Agent
อยากเห็นระบบ RAG ทำงานจริง กดเล่นได้เลย
เราสร้างเดโมทีมตัวแทนประกัน AI 8 ตัวไว้ให้ลอง พิมพ์ถามได้จริง ตอบจากคลังความรู้ของบริษัทสมมุติที่เราเตรียมไว้ เปิดดูหลังบ้านได้ ไม่ต้องสมัครอะไร
ลองเล่นเดโม RAG + AI Agent →3 กรณีที่ยังไม่ควรใช้ RAG
ตอบตรงๆ เลยว่าไม่ใช่ทุกงานที่ต้องมี RAG
- เอกสารมีไม่กี่หน้า ยัดเข้าคำสั่งตรงๆ ถูกกว่า เร็วกว่า ไม่ต้องสร้างระบบค้น
- เอกสารยังขัดแย้งกันเอง คู่มือ 2 ฉบับตอบไม่ตรงกัน AI อาจเลือกตอบฉบับใดฉบับหนึ่งอย่างมั่นใจ จัดระเบียบเอกสารให้จบก่อน
- คำถามต้องคำนวณหลายชั้น RAG เก่งเรื่อง "ค้นแล้วตอบ" ไม่ใช่เครื่องคิดเลข งานที่ต้องคำนวณเบี้ย/ส่วนลดซับซ้อนต้องออกแบบส่วนคำนวณแยก
3 สิ่งที่ต้องระวังเมื่อทำระบบ RAG
คุณภาพคำตอบขึ้นกับหลายอย่างร่วมกัน ทั้งคุณภาพเอกสาร วิธีค้น คำสั่งที่ให้โมเดล และการทดสอบ ส่วน 3 ข้อด้านล่างต้องวางแผนตั้งแต่ตอนออกแบบคลัง ไม่ใช่มาแก้ทีหลัง
- คุณภาพเอกสารและกรณีไม่พบข้อมูล ถ้าคู่มือขัดแย้งกันเองหรือหมดอายุ AI ก็มีแนวโน้มตอบตามนั้น โปรเจกต์ RAG ที่ดีจึงมักเริ่มจากจัดระเบียบเอกสารก่อน และควรออกแบบให้ระบบตอบว่าไม่พบเมื่อไม่มีเอกสารรองรับ พร้อมมีปุ่มให้ผู้ใช้กด "คำตอบนี้ผิด" เพื่อปรับปรุงต่อเนื่อง ทั้งสองอย่างต้องตั้งใจทำและทดสอบ ไม่ได้มาเองกับ RAG
- สิทธิ์การเข้าถึง เอกสารเงินเดือนหรือสัญญาลูกค้าบางฉบับ ห้ามโผล่ในคำตอบของพนักงานทั่วไป คลังความรู้ต้องแยกโซนตามสิทธิ์ตั้งแต่แรก
- เอกสารหมดอายุ ราคาปีที่แล้ว โปรโมชันที่จบไปแล้ว ถ้าไม่ถูกถอดออกจากคลัง AI อาจดึงไปตอบ ต้องกำหนดว่าใครเป็นคนถอด และถอดเมื่อไหร่
อยากให้ AI ตอบจากเอกสารของบริษัทคุณเองแบบนี้ มี 2 ทางตามสถานะของคุณ ถ้ายังประเมินอยู่ว่าพร้อมไหมและต้องเตรียมอะไร อ่าน จ้างทำระบบ RAG ต้องเตรียมอะไร ก่อนจ่ายเงินจริง ก่อน ถ้าเอกสารพร้อมแล้วและอยากคุยขอบเขตงาน ไปที่หน้าบริการ AI Agent และ Chatbot ของเรา คุยรอบแรกฟรี
คำถามที่พบบ่อย
RAG AI คืออะไร ถ้าอธิบายให้คนไม่ใช่สายเทคนิค
คือวิธีให้ AI ค้นเอกสารของบริษัทคุณก่อนตอบครับ ปกติ AI ตอบจากสิ่งที่เรียนมาตอนฝึก RAG เพิ่มขั้นตอนค้นข้อมูลที่เกี่ยวข้องจากเอกสารของคุณ แล้วส่งเป็นบริบทให้โมเดลก่อนตอบ คำตอบจึงมีเอกสารจริงเป็นบริบท ระบุที่มาได้ถ้าออกแบบไว้ และยังต้องทดสอบความถูกต้อง ไม่ต้องสร้างโมเดลใหม่
RAG กับ Fine-tuning ต่างกันยังไง
Fine-tuning คือฝึกโมเดลเพิ่ม เหมาะกับการปรับพฤติกรรมหรือสไตล์การตอบ จะเปลี่ยนสิ่งที่โมเดลเรียนไว้ต้องฝึกใหม่ครับ RAG เก็บข้อมูลไว้นอกโมเดลเป็นคลังเอกสาร อัปเดตไฟล์และสร้างดัชนีใหม่ คำถามถัดไปก็มีเอกสารชุดใหม่ให้ดึง ส่วนคำตอบจะตามแค่ไหนต้องทดสอบ งานข้อมูลองค์กรที่เปลี่ยนบ่อยจึงเหมาะกับ RAG มากกว่า
RAG chatbot ต่างจากแชตบอตทั่วไปตรงไหน
แชตบอตทั่วไปมักตอบตามสคริปต์ ฐานข้อมูลที่ต่อไว้ หรือความรู้ของโมเดลครับ RAG chatbot ค้นเอกสารของบริษัทก่อนตอบ เช่น คู่มือ ราคา เงื่อนไข และบอกที่มาได้ถ้าออกแบบไว้ ส่วนการบอกว่าไม่พบแทนการเดาเมื่อถามเรื่องที่ไม่มีในเอกสาร เป็นสิ่งที่ต้องออกแบบและทดสอบ ไม่ได้เกิดเองจากการติด RAG
ทำระบบ RAG ให้บริษัทต้องเตรียมอะไรก่อน
เริ่มจากเอกสารครับ จัดระเบียบให้ไม่ขัดแย้งกันเอง แยกว่าเอกสารไหนใครเห็นได้ กำหนดคนถอดเอกสารหมดอายุ และเตรียมคำถามจริงไว้ทดสอบรวมถึงคำถามที่ไม่มีในเอกสาร ขอบเขตงานและสิ่งที่ต้องดูก่อนจ่ายอยู่ในบทความจ้างทำระบบ RAG ของเรา คุยรอบแรกฟรี ไม่มีข้อผูกมัด